Warum dasselbe KI-Modell für die eine Person nützlich und für die andere inakzeptabel sein kann. Studien, Nutzerberichte und ein praktischer Weg, die eigene Qualitätsschwelle zu prüfen.
Zwei Entwickler sehen sich dasselbe KI-generierte Exportskript an. Es erzeugt die gewünschte Datei. Der erste nennt das Modell hervorragend. Der zweite würde diesen Code nie in sein Projekt lassen.
In diesem hypothetischen Fall braucht der erste einen einmaligen Export aus bekannten Daten und prüft das Ergebnis von Hand. Der zweite braucht eine wiederverwendbare Funktion, die Berechtigungen erhält und fehlende Felder verarbeitet. Dasselbe Skript erfüllt den einen Auftrag und scheitert am anderen.
„Dieses Modell ist gut“ wird brauchbar, wenn du ergänzt: für welche Arbeit, nach wessen Abnahmeregeln und mit wie viel Hilfe. Modelle unterscheiden sich in ihren Fähigkeiten. Unsere Anforderungen bestimmen, welche Unterschiede zählen. Manchmal liegt die Messlatte einer Person höher. Manchmal geht es ihr um eine andere Dimension. Manchmal hat jemand einen Fehler übersehen.
Ein hilfreicher Vergleich macht diese Bedingungen sichtbar.
Ausgangslage und Messlatte sind verschieden
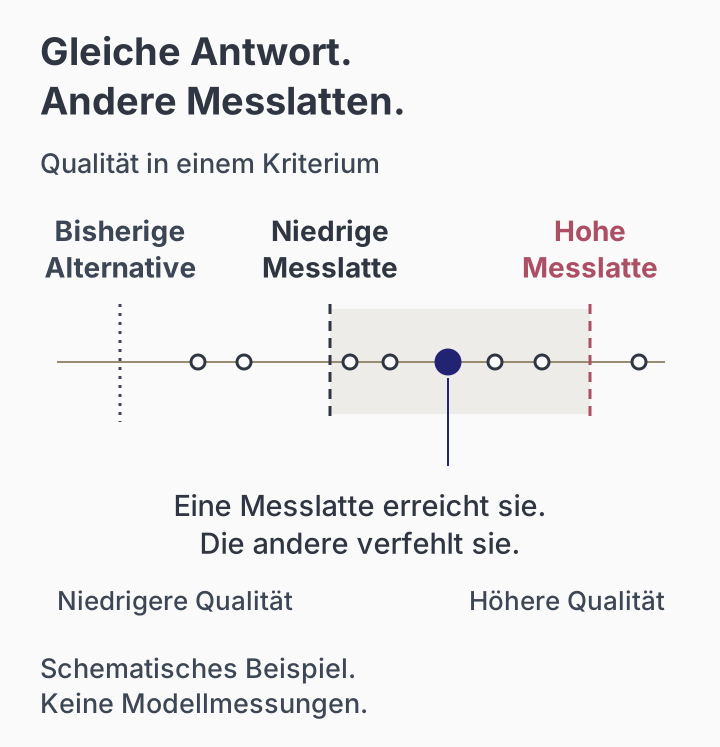
Deine Ausgangslage ist die verfügbare Alternative: deine eigene Arbeit, die Hilfe einer Kollegin, eine Suchmaschine oder die Entscheidung, die Aufgabe liegen zu lassen. Deine Messlatte ist das Mindestergebnis, das du für diese Aufgabe akzeptierst.
Wer eine E-Mail in einer Fremdsprache schreibt, gewinnt mit einem schlichten, korrekten Entwurf vielleicht schon viel. Eine professionelle Lektorin lehnt denselben Entwurf womöglich ab, weil er den persönlichen Ton verwischt. Die Verbesserung ist echt. Die verbleibende Arbeit ebenfalls.
Brynjolfsson, Li und Raymond untersuchten die gestaffelte Einführung eines KI-Assistenten bei 5.172 Beschäftigten im Kundensupport. Die Zahl gelöster Anfragen pro Stunde stieg im Schnitt um 15 %. Weniger erfahrene und weniger geübte Beschäftigte profitierten stärker. Die erfahrensten und leistungsstärksten wurden nur wenig schneller, ihre Qualität sank leicht.1 In diesem Support-Umfeld verdeckte der Durchschnitt Unterschiede nach Können und Erfahrung.
Eine Verbesserung gegenüber deiner Ausgangslage kann trotzdem hinter den Anforderungen zurückbleiben. Die deutlich bessere Übersetzung eines Anfängers braucht vor der Veröffentlichung vielleicht eine Fachperson. Umgekehrt kann ein Modell alle Anforderungen erfüllen und wenig Zeit sparen, weil du die Arbeit ohnehin schnell erledigst. „Besser als meine Alternative“ und „einsatzbereit“ brauchen getrennte Antworten.
Die Antwort bleibt gleich. Das Urteil ändert sich. Die Punkte sind erfundene Beispiele für ein Kriterium, keine Messwerte oder ein allgemeiner Qualitätsmaßstab.
Eine höhere Messlatte hängt von der Aufgabe ab
Manche Anforderungen sind schlicht strenger als andere. Zehn bekannte Eingaben zu verarbeiten verlangt weniger, als beliebige Kundeneingaben korrekt zu behandeln. Ein grober Entwurf darf mehr offene Stellen enthalten als eine versandfertige Nachricht.
Andere Unterschiede lassen sich nicht sinnvoll in höher oder niedriger ordnen. Eine Romanautorin verlangt vielleicht unverwechselbare Dialoge und nimmt langsame Antworten in Kauf. Wer Routineantworten formuliert, legt eher Wert auf Tempo und Konsistenz. Offline arbeiten zu müssen ist eine Einschränkung, die kein Benchmark-Wert aufhebt.
Aufgabe
Genügt
Fällt durch
Einladungsideen
Brauchbarer Ausgangspunkt
Falscher Ton
E-Mail überarbeiten
Fakten und Bedeutung bleiben
Erfundenes Versprechen
Einmaliger Export
Für diese Daten korrekt
Fehlende oder veränderte Einträge
Gemeinsame Anwendung
Verhalten und Projektregeln stimmen
Fehlerhafte Berechtigungen
Das sind beispielhafte Regeln. Die Person, die die Einladung schreibt, kann auch für die Anwendung verantwortlich sein. Ihre Messlatte wandert mit der Aufgabe.
Fachwissen wirkt in beide Richtungen. Eine erfahrene Entwicklerin erkennt vielleicht einen subtilen Fehler und lehnt den Code ab. Sie akzeptiert vielleicht einen unvollkommenen Entwurf, weil sie ihn günstig reparieren kann. Wer diesen Code nicht prüfen kann, verlangt vernünftigerweise mehr unabhängige Überprüfung.
Weniger Feinschliff zu akzeptieren ist eine Entscheidung. Einen Fehler zu übersehen heißt, noch nicht festgestellt zu haben, ob das Ergebnis die eigene Messlatte erreicht. Persönliche Vorlieben machen eine falsche Berechnung nicht richtig.
Eine Empfehlung bringt fremde Anforderungen mit
Ein Benchmark legt Aufgaben und Bewertungsregeln fest, um Modelle vergleichbar zu machen. Sein Sieger ist ein brauchbarer Kandidat, wenn diese Bedingungen deinen ähneln. Eine Präferenzrangliste beantwortet eine andere Frage: Welche Ergebnisse gefielen den Abstimmenden besser?
Eine Studie in den Findings of ACL von 2026 erstellte persönliche Ranglisten für 115 aktive Nutzende der Chatbot Arena mit jeweils mindestens 25 Vergleichen. Die mittlere Korrelation mit der Gesamtrangliste lag bei 0,04 mit Bradley-Terry-Schätzungen und bei 0,43 mit Elo. Ein Wert von 1 bedeutet identische Reihenfolgen. 0 bedeutet keinen Zusammenhang der Rangfolgen. Das methodenabhängige Ergebnis liefert Hinweise auf unterschiedliche Präferenzen in dieser ausgewählten Stichprobe. Eine stabile Rangliste für alle folgt daraus nicht.2
Eine bevorzugte Antwort muss außerdem nicht richtig sein. Flüssigere Prosa gleicht eine erfundene Zusage in einer Kunden-E-Mail nicht aus.
Öffentliche Berichte machen konkrete Anforderungen greifbar. Am 17. Oktober 2025 beschrieb nNaz auf Reddit die Arbeit an komplexen Finanz-Codebasen. Für Recherche und Implementierung kam Sonnet 4.5 zum Einsatz. Opus blieb dem Schritt vorbehalten, aus den Ergebnissen einen Plan zu machen. Die Kritik betraf das Verständnis zusammenhängender Projektteile und restriktive Nutzungslimits.3
Fünf Tage später berichtete ak47surve, sich mit Sonnet 4.5 genauso produktiv zu fühlen wie im früheren Workflow mit Opus. Die störenden Limits zu vermeiden gehörte zum Nutzen.4
Außerhalb des Programmierens bevorzugte Sammi_W in einem Forumsbeitrag vom 7. Februar 2025 Geminis experimentelle Version „1206“ gegenüber „0205“ fürs Schreiben. Als Gründe nannte der Beitrag Wiederholungen sowie eine weniger stimmige Fortführung von Handlung und Figuren in „0205“.5 Der Maßstab umfasste, eine Geschichte zusammenzuhalten. Ein einzelner schöner Absatz reicht dafür nicht.
Diese datierten Berichte liefern Prüfkriterien, keine aktuellen Kaufempfehlungen. Die freiwillig veröffentlichten Erfahrungen belegen weder Verbreitung noch wessen Messlatte höher lag. Ohne kontrollierten Vergleich von Aufgaben, Einstellungen, Prompts und Prüfung klären sie auch die Ursache der Uneinigkeit nicht.
Nutze sie für genauere Fragen an deine Arbeit: Kann das Modell dieses Projekt überblicken, diese Figurenstimme erhalten oder verfügbar bleiben, wenn du es brauchst?
Beurteile den ganzen Auftrag
Eine brillante Antwort zeigt, was ein Modell einmal kann. Ein verlässlicher Workflow verlangt, dass es deine Anforderungen wiederholt erfüllt, auch bei den unauffälligen Teilen.
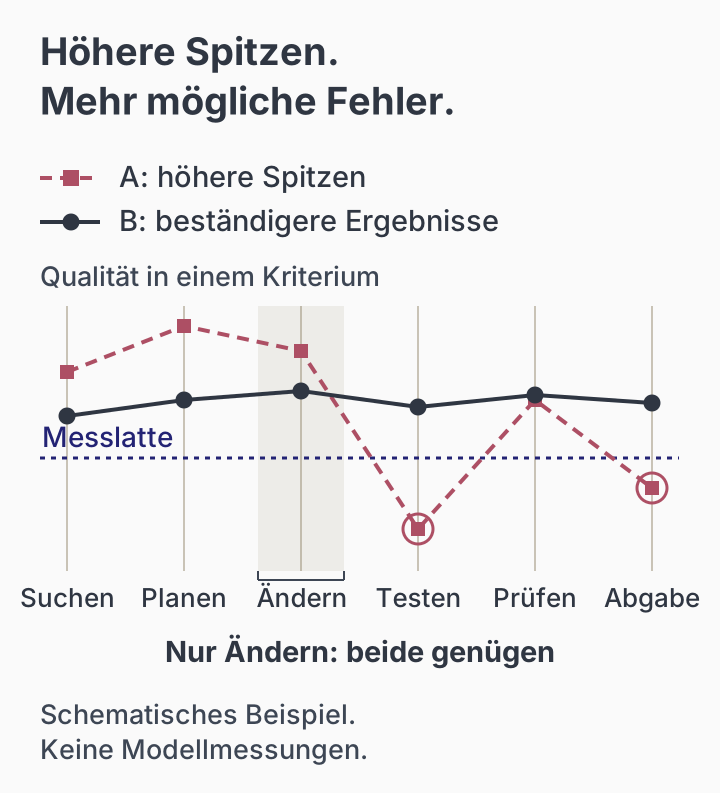
Zurück zum Exportskript. Bittest du um eine Änderung an einer bekannten Funktion, bleiben die Ursachensuche und die Prüfung des Ergebnisses bei dir. Delegierst du das ganze Problem, kommen Untersuchung, Planung, Tests und Übergabe hinzu. Die einzelnen Schritte müssen dadurch nicht schwieriger werden. Das Modell übernimmt Verantwortung für mehr Stellen, an denen etwas schiefgehen kann.
Ein Test nur der Änderung ließe beide Modelle geeignet wirken. Im gesamten erfundenen Auftrag verfehlt A zwei Anforderungen, B erfüllt alle. Die Verläufe sind schematisch und keine Benchmark-Ergebnisse.
Die höheren Spitzen von Modell A reparieren keine verletzten Anforderungen. Modell B erreicht die Messlatte in dieser Darstellung durchgehend. In der Praxis garantiert das schlechteste bisher beobachtete Ergebnis keine Untergrenze für künftige Antworten. Halte fest, wie oft und wie deutlich das Modell scheitert und ob es seine Fehler erkennt und korrigiert.
Zeit ohne Eingreifen und Qualität bei der Übergabe sind verschiedene Maße. Ein Agent kann weiterlaufen, ohne sinnvoll voranzukommen. Stoppt er wegen einer fehlenden Berechtigung und meldet das, bleibt eine sichtbar offene Aufgabe. Ein stillschweigend falsches Ergebnis verursacht ein weiteres Prüfproblem. Mehr Autonomie ist wertvoll, wenn sie akzeptable Arbeit mit weniger deiner Aufmerksamkeit liefert.
Stell dir zwölf Stufen vor, die unabhängig voneinander mit derselben Wahrscheinlichkeit gelingen. Jede Stufe muss gelingen, und es gibt keine Möglichkeit, einen Fehler aufzufangen. Bei 95 % Erfolg pro Stufe liegt die Chance auf einen vollständig erfolgreichen Durchlauf bei etwa 54 %. Bei 99 % sind es etwa 89 %, berechnet als 0.95^12 und 0.99^12.
Die Wahrscheinlichkeiten sind erfunden. Echte Stufen unterscheiden sich, Fehler können zusammenhängen, und Agenten können sie auffangen. Die Rechnung zeigt, wie sich weitere Fehlermöglichkeiten auswirken. Sie misst kein Modell und sagt keine autonome Laufzeit voraus.
Ein brauchbares Urteil beschreibt, wie oft ein vollständiger Auftrag deine Anforderungen innerhalb deines Zeit- und Geldbudgets erfüllt. Rechne gescheiterte Versuche mit. Eine beeindruckende Demo oder eine katastrophale Antwort kann diese Häufigkeit nicht belegen.
Alte Erfahrung kann ein neues Urteil verankern
Deine Erwartung ist das, was du dem Modell zutraust. Sie kann sowohl von deiner vorhandenen Alternative als auch vom benötigten Ergebnis abweichen.
Nach wiederholten Fehlschlägen bei umfangreichen Aufträgen beschränkst du einen Assistenten vielleicht auf kleine Änderungen. Wenn zwei neuere Modelle diese bewältigen, zeigt dein Vergleich, dass sie für diesen engen Workflow taugen. Über die Untersuchung oder Prüfung, die du nicht mehr delegierst, sagt er wenig.
Prüfe diese Grenze neu, wenn sich Modell oder Arbeitsumgebung ändern. Bei gleichen Anforderungen weniger Schritte zu delegieren verkleinert den Auftrag. Schlechtere Ergebnisse zu akzeptieren senkt die Messlatte. Besserer Kontext oder bessere Werkzeuge können die Leistung bei unveränderter Messlatte erhöhen. Wer diese Entscheidungen vermischt, verdeckt, was sich tatsächlich geändert hat.
Erwartungen können auch ein schwaches Ergebnis gut wirken lassen. Ein Preprint von 2026, im August überarbeitet, testete die Darstellung von Fähigkeiten mit 162 Teilnehmenden und sechs Modellen. Wie Forschende ein Modell vorstellten, beeinflusste Eindrücke und Interaktion. Ein Effekt dieser Darstellung auf die Ergebnisqualität war nicht nachweisbar. Die kurzen Aufgaben und die englischsprachige US-Stichprobe begrenzen die Verallgemeinerung.6 Prüfe die Arbeit gegen Regeln, die du festgelegt hast, bevor das Modell dich beeindrucken oder enttäuschen konnte.
Rechne deine Aufmerksamkeit in den Preis ein
Die Kosten eines akzeptablen Ergebnisses umfassen Vorbereitung, Wartezeit, Prüfung, Korrekturen und gescheiterte Versuche. Token-Preise decken nur einen Teil davon ab. Ein günstigeres Modell kann mehr von deiner Zeit verlangen. Ein teureres bringt vielleicht nichts zusätzlich, wenn beide die Anforderungen bereits erfüllen.
In der Stack-Overflow-Umfrage 2025 nannten 66 % der 31.476 Personen, die die Frustrationsfrage beantworteten, fast richtige KI-Lösungen als Problem. Das beschreibt eine selbst berichtete Frustration und ist keine Fehlerquote für generierten Code.7 Ein Fehler, den du in Sekunden behebst, kostet etwas anderes als einer, den du eine Stunde lang suchen musst.
Prüfen gehört zur Arbeit. Seine Kosten gehören in den Vergleich. Konzeptuelle Illustration, mit KI erzeugt.
Die eigene Zeit lässt sich aus dem Gedächtnis schwer einschätzen. In METRs Experiment von Anfang 2025 bearbeiteten 16 erfahrene Entwickler 246 Aufgaben in Repositories, die sie kannten. Die Erlaubnis, KI zu nutzen, verlängerte die Bearbeitungszeit um 19 %. Hinterher schätzten die Teilnehmenden, sie seien durch KI 20 % schneller gewesen.8 Das Ergebnis betrifft dieses Umfeld und die damaligen Werkzeuge.
METRs Folgestudie vom Februar 2026 zeigte Hinweise auf einen größeren Nutzen, stufte die neue Produktivitätsschätzung aber als unzuverlässig ein. Manche Entwickler nahmen nicht teil und manche Aufgaben kamen nicht in die Studie, weil Beteiligte nicht auf KI verzichten wollten. Niedrigere Bezahlung konnte die Auswahl zusätzlich beeinflussen. Parallel laufende Agenten erschwerten die Zeitmessung.9 Keine der Studien liefert eine allgemeingültige Zahl für den Zeitgewinn. Sich weniger erschöpft zu fühlen kann selbst wertvoll sein, ist aber ein anderes Ergebnis als früher fertig zu werden.
Ein Beispiel: 1 € und 25 Minuten deiner Aufmerksamkeit oder 4 € und fünf Minuten, bei gleicher Endqualität. Die zusätzlichen 3 € kaufen zwanzig Minuten zurück. Das kann sich im Beruf lohnen und bei festem Geldbudget unbezahlbar sein. Gesparte Zeit wird nicht automatisch zu verfügbarem Geld.
Vergleiche die gesamte Arbeitsumgebung: Modellversion, Reasoning-Einstellung, Werkzeuge, Kontext und dein Eingreifen. Zugriff auf das Repository und funktionierende Tests verändern, welche Arbeit ein Agent erledigen kann. Sieh nach einem Fehlschlag nach, was er tatsächlich gelesen, verändert und geprüft hat. Ergänze fehlenden Kontext oder repariere Werkzeuge, wenn die Belege diese Diagnose stützen. Manche Fehler bleiben Grenzen des Modells. Rechne die Arbeit an der Umgebung ebenfalls mit.
Mach dein Urteil für andere brauchbar
Eine persönliche Bewertung braucht ein paar echte Aufgaben und Abnahmeregeln, die du aufschreibst, bevor du die Antworten siehst.
Wähle typische Arbeit. Nimm Routineaufgaben und einen Auftrag, den du nach früheren Fehlschlägen nicht mehr delegiert hast. Werte diesen neuen Versuch getrennt aus.
Lege fest, was genügt. Für eine E-Mail: jeden Fakt erhalten und keine Zusage erfinden. Für Code: Verhalten, Prüfungen und Umfang festlegen. Benenne Fehler, die eine Antwort disqualifizieren.
Notiere die Bedingungen. Starte mit demselben Kontext, denselben Werkzeugen und demselben Budget. Halte Modellversionen und Einstellungen fest. Wenn du jeden Workflow einzeln abstimmst, rechne diese Vorbereitung getrennt mit.
Prüfe und wiederhole. Verdecke Modellnamen, wo praktikabel. Erfasse akzeptable Ergebnisse, Eingriffe und die Zeit bis zum geprüften Abschluss über mehrere Versuche. Eine kleine Stichprobe liefert lokale Anhaltspunkte, keine genaue Fehlerquote.
Entscheide für die Aufgabe. Bevorzuge die Arbeitsumgebung, die deine Anforderungen innerhalb deines Budgets erfüllt. Überprüfe das Urteil, wenn sich Aufgabe, Modell oder Prüfprozess ändern.
Das Ergebnis könnte lauten: „Für Routineantworten auf Deutsch erhält dieses Modell die Fakten und braucht nur eine kurze sprachliche Korrektur. Jedes Datum prüfe ich weiterhin.“
Oder: „Für Änderungen über mehrere Teile dieses Repositorys braucht das andere Modell weniger Korrekturen, bis alle Prüfungen erfolgreich sind. Das rechtfertigt seine Kosten.“
Jedes Urteil gibt der nächsten Person etwas zum Abgleich mit ihren eigenen Anforderungen. Frag, welche Arbeit die Messlatte erreicht und wie viel menschliche Arbeit dafür nötig ist.